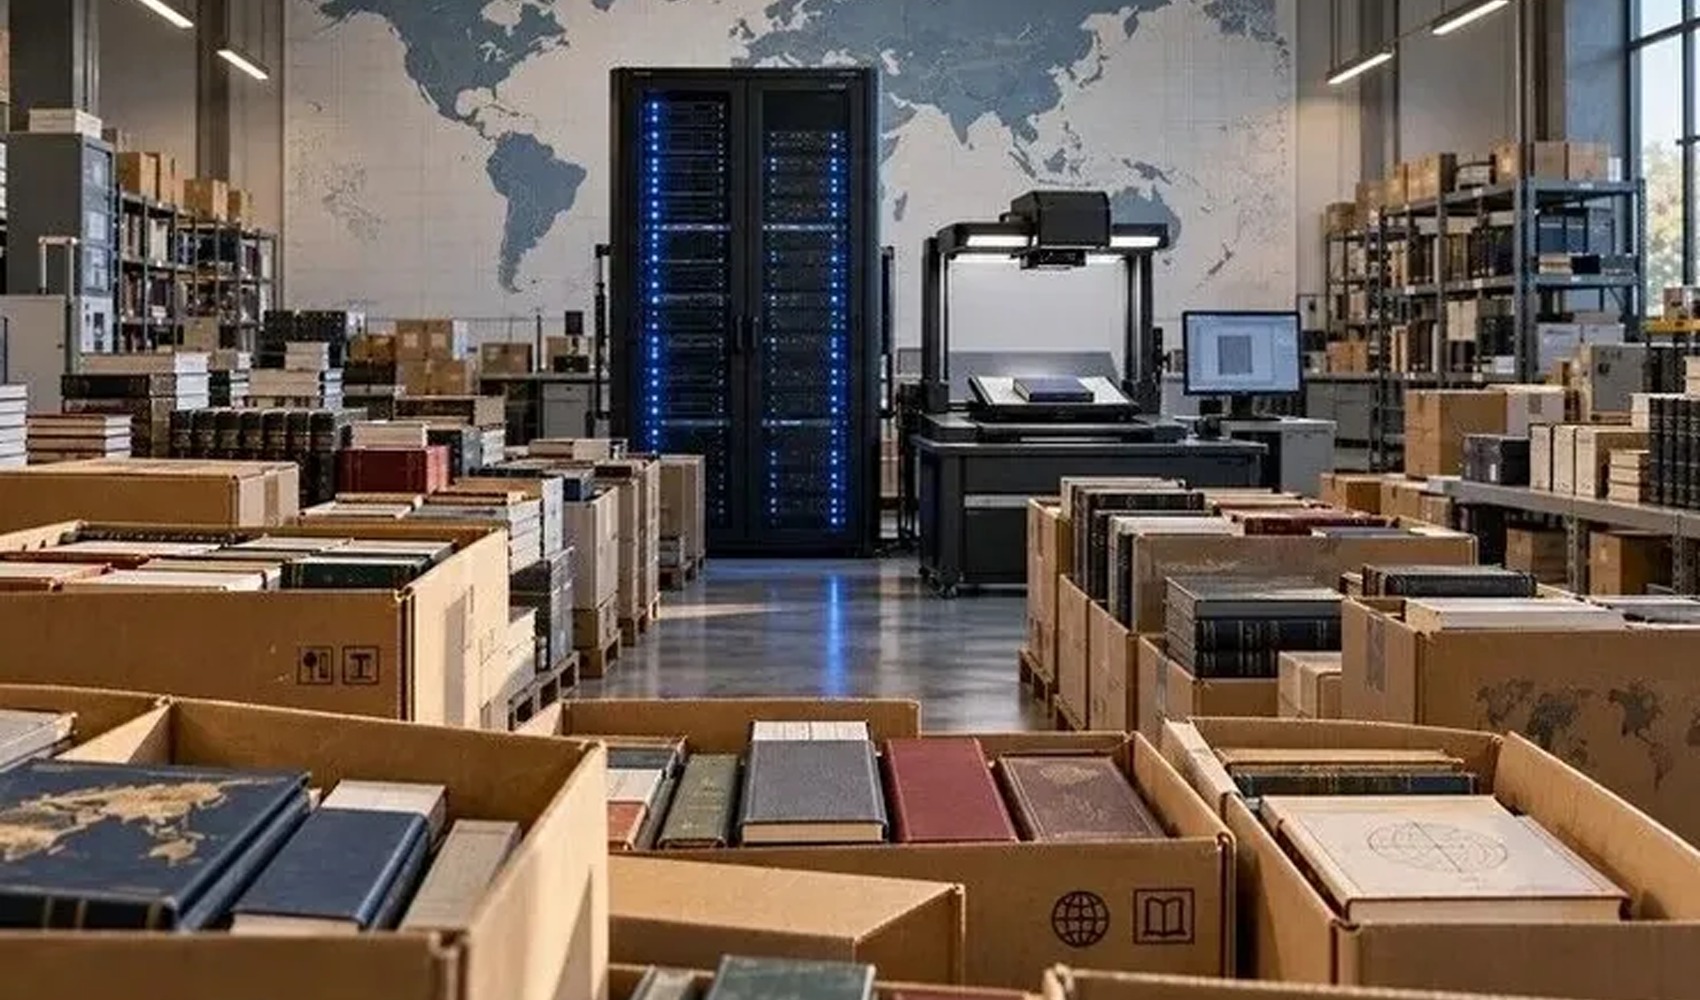
Los intentos de las empresas de inteligencia artificial por convertir libros impresos y digitales en conjuntos de datos a gran escala han vuelto a poner sobre la mesa el debate sobre los derechos de autor y el uso de datos en el sector editorial.
El profesor Selçuk Beşir Demir declaró que rechazaron la solicitud de una empresa global para acceder a 17 mil libros académicos. Demir enfatizó que tales solicitudes no pueden verse simplemente como una actividad técnica de recopilación de datos, sino que podrían tener consecuencias graves para los editores, los autores y la producción académica.
Al describir el proceso como una "guerra entre Silicon Valley y la industria de la celulosa", Demir señaló que los mecanismos de derechos de autor y permisos deben protegerse en los contenidos utilizados para el entrenamiento de modelos de inteligencia artificial.
La principal preocupación en el mundo editorial es que, al escanear libros de forma masiva y utilizarlos para entrenar sistemas de inteligencia artificial, se debiliten los derechos de ingresos, control y citación de los autores. Se afirma que esta situación podría aumentar el riesgo de "explotación de datos" y la contracción del mercado, especialmente para las publicaciones académicas en turco.
Demir hizo un llamado a establecer un marco de protección más sólido contra las infracciones de derechos de autor, al tiempo que expresó que la producción de contenido local debe garantizarse en el proceso de transformación digital de la edición académica.
Fuente de la noticia: 12punto